
Najgroźniejszy błąd grafu relacji powstaje zanim zostanie wykonany pierwszy PageRank. System musi zdecydować, czy Jan Kowalski z rejestru A, J. Kowalski z pliku B i posiadacz telefonu z systemu C są tą samą osobą. Fałszywe scalenie połączy ich rodziny, firmy, urządzenia, sprawy i obserwacje. Fałszywe rozdzielenie ukryje prawdziwą ścieżkę.
Entity resolution nie jest fuzzy joinem po nazwisku. To kontrolowany proces tworzenia i wersjonowania hipotez o tożsamości rekordów. Musi obsłużyć identyfikatory pewne i błędne, zmianę danych w czasie, transliterację, bliźnięta, ponowne użycie telefonu, kradzież dokumentu, rekordy organizacji oraz odwracanie wcześniejszych decyzji.
W teorii grafów relacji encja jest wierzchołkiem, a źródłowy rekord osobnym obiektem. Tutaj budujemy mechanizm, który wiąże jedno z drugim bez udawania pewności, której dane nie zapewniają.
Cztery różne problemy ukryte pod jedną nazwą
Deduplication
W jednym zbiorze znajdują się dwa rekordy tej samej rzeczy. Urząd ma dwa wpisy przedsiębiorcy po migracji starego systemu.
Record linkage
Łączymy rekordy z dwóch zbiorów, np. rejestr mieszkańców z bazą licencji. Źródła mogą mieć różne standardy i opóźnienia.
Entity resolution
Tworzymy trwałą encję z wielu rekordów, utrzymujemy historię przypisań i konflikty. Wynikiem jest cluster, nie tylko para.
Entity linking
Wzmiankę w tekście albo obserwację przypisujemy do encji z katalogu. Jaguar może oznaczać osobę o pseudonimie, markę auta albo zwierzę.
W państwowej platformie występują wszystkie cztery. Ich metryki nie są identyczne. Dobry pair classifier nie gwarantuje dobrych wielorekordowych klastrów.
Rekord nie jest osobą
Bezpieczny model zawiera co najmniej:
SourceRecord
  source_system
  source_record_id
  payload_hash
  valid_from / valid_to
  ingested_at
  raw_reference

ResolvedEntity
  entity_id
  entity_type
  created_at
  status

ResolutionAssertion
  record_id → entity_id
  method
  score
  model_version
  feature_snapshot
  decided_at / revoked_at
  reviewer
Nie kopiujemy wszystkich pól do jednego „golden record” i nie usuwamy źródeł. Canonical view jest wyliczana według jawnych reguł. Nazwisko może pochodzić z jednego rejestru, adres z drugiego, a data śmierci z trzeciego. Każda wartość wskazuje pochodzenie.
W grafie SourceRecord może być połączony krawędzią IDENTIFIES z Person. Kandydat ma osobny typ SAME_ENTITY_CANDIDATE. Dzięki temu algorytm analizy relacji nie pomyli propozycji z zatwierdzonym scaleniem.
Deterministyczne klucze są pierwszą linią, nie całą odpowiedzią
PESEL, CitizenID, USCC, NIP, KRS albo numer dokumentu potrafią rozstrzygać dużą część rekordów. Muszą jednak przejść walidację:
- długości i alfabetu;
- cyfry kontrolnej;
- dopuszczalnego zakresu dat;
- zgodności typu podmiotu;
- statusu wydania lub unieważnienia;
- źródła i poziomu zaufania;
- konfliktu z innym rekordem.
Identyczny poprawny PESEL w dwóch wiarygodnych rejestrach jest mocnym dowodem. Ten sam ciąg w dwóch plikach CSV importowanych z jednego błędnego źródła nie daje dwóch niezależnych dowodów.
Nie wolno także zakładać, że jeden numer zawsze znaczy jedną encję przez całą historię. Identyfikatory techniczne bywają ponownie używane, źle przepisywane albo zastępowane. Telefon, rachunek, tablica rejestracyjna i adres są relacjami czasowymi, nie kluczem osoby.
Normalizacja: zachować surowe i porównywać znormalizowane
Każde pole powinno mieć trzy reprezentacje:
- wartość surową, niezmienioną;
- wersję znormalizowaną do porównania;
- wynik parsera z informacją o błędach.
Imię i nazwisko
Możliwe kroki to Unicode normalization, ujednolicenie wielkości, odstępów, znaków łącznika, tytułów i kolejności. Polskie znaki nie powinny być bezpowrotnie usuwane; Łukasz i Lukasz są podobne, ale transliteracja zwiększa liczbę kolizji.
Nazwy chińskie wymagają osobnego traktowania znaków uproszczonych i tradycyjnych, pinyin, kolejności nazwiska oraz wariantów transliteracji. Nie istnieje jeden bezpieczny lower(trim(name)) dla wszystkich języków.
Adres
Parser rozdziela kraj, kod, miejscowość, ulicę, numer budynku i lokalu. Korzysta ze słownika ulic i historii zmian nazw. Geokod jest cechą dodatkową, nie zastępuje tekstu. Blok mieszkalny z tysiącem mieszkańców jest słabszym sygnałem niż numer lokalu.
Telefon i e-mail
Telefon normalizujemy do formatu międzynarodowego, zachowując kraj założony przez regułę. E-mail można normalizować ostrożnie: domena jest case-insensitive, lokalna część formalnie nie musi być. Usuwanie kropek charakterystyczne dla jednego dostawcy nie powinno być globalną regułą.
Data
Data 03/04/05 jest niejednoznaczna. Parser zachowuje format wejściowy, locale i pewność. Dla przybliżonego roku urodzenia nie tworzy arbitralnie 1 stycznia.
Candidate generation: nie porównujemy wszystkiego ze wszystkim
Dwa zbiory po 50 mln rekordów dają 2,5 biliarda par. Trzeba stworzyć mniejszy zbiór kandydatów z wysokim recall.
Blocking deterministyczny
Przykładowe bloki:
- ten sam poprawny identyfikator;
- nazwisko fonetyczne + rok urodzenia;
- kod pocztowy + pierwsze znaki nazwiska;
- hash telefonu;
- domena e-mail + podobne imię;
- geohash adresu + przedział wieku.
Jedna reguła blokowania jest krucha. Stosuje się wiele bloków, a pary deduplikuje. Osoba pominięta w jednym bloku może wejść przez inny.
Sorted neighbourhood
Rekordy sortuje się według znormalizowanego klucza i porównuje w przesuwanym oknie. Literówka może nadal znaleźć się blisko poprawnej nazwy. Wielkość okna kontroluje koszt i recall.
LSH i approximate nearest neighbours
MinHash/LSH pomaga dla podobieństwa zbiorów tokenów. ANN może wyszukiwać podobne wektory nazw lub adresów. Embedding jest generatorem kandydatów, nie dowodem tożsamości. Model językowy potrafi uznać dwie semantycznie podobne instytucje za tę samą, choć prawnie są różne.
Cechy porównania
Dla każdej pary tworzymy wektor cech, a nie jedno „similarity”.
String similarities
- Levenshtein liczy minimalne edycje;
- Damerau–Levenshtein uwzględnia transpozycję;
- Jaro i Jaro–Winkler premiują wspólny początek;
- Jaccard porównuje zbiory tokenów lub n-gramów;
- cosine porównuje wektory częstotliwości;
- phonetic keys przybliżają wymowę w konkretnym języku.
Wynik 0,92 nie ma uniwersalnego znaczenia. Dla krótkiego nazwiska jedna litera zmienia dużo; dla długiej nazwy firmy niewiele.
Exact i contradiction features
Zgodność poprawnego PESEL jest mocna. Niezgodność daty urodzenia o jeden dzień może być literówką; różnica 30 lat jest silną sprzecznością. System potrzebuje cech negatywnych, nie tylko sumy podobieństw.
Rarity
Zgodność nazwiska Nowak daje mniej informacji niż rzadkiego nazwiska. Zgodność popularnego adresu wirtualnego prawie nic nie znaczy. Cechy muszą wykorzystywać częstość wartości w właściwej populacji i czasie.
Relational features
Wspólny małżonek, konto albo wcześniejszy adres może pomóc. Grozi to sprzężeniem zwrotnym: graf zbudowany z błędnego scalenia staje się dowodem kolejnego scalenia. Cechy relacyjne powinny pochodzić wyłącznie z zatwierdzonych relacji, mieć wersję snapshotu i ograniczoną wagę.
Model Fellegiego–Suntera
Klasyczny model dzieli pary na matches M i non-matches U. Dla wzorca zgodności γ ocenia:
m(γ) = P(γ | M)
u(γ) = P(γ | U)
w(γ) = log(m(γ) / u(γ))
Jeżeli zgodność rzadkiego identyfikatora występuje często u prawdziwych par i prawie nigdy u losowych, daje dużą dodatnią wagę. Niezgodność daty może dać wagę ujemną. Sumaryczny log-likelihood ratio porównuje się z dwoma progami:
- powyżej górnego: link;
- poniżej dolnego: non-link;
- pomiędzy: possible link do dalszej oceny.
Trójdecyzyjny model jest lepszy niż wymuszenie odpowiedzi na każdej parze. Oryginalna teoria Fellegiego i Suntera formalizowała kontrolę oczekiwanych błędów przy danych progach.1
Założenie warunkowej niezależności cech często nie zachodzi. Imię koreluje z płcią i kulturą, kod z miejscowością, a telefon z adresem. Model nadal bywa skuteczny, lecz wymaga kalibracji oraz testów w podgrupach.
Uczenie parametrów
Dane etykietowane
Najlepszy zbiór zawiera trudne matches i hard negatives, nie tylko oczywiste pary. Etykietujący otrzymuje źródła i instrukcję, a nie wynik modelu. Część par ocenia dwóch niezależnych ekspertów; rozbieżności rozstrzyga trzeci.
EM
Expectation–maximization może oszacować parametry bez pełnego zbioru etykiet. E-step wylicza prawdopodobieństwo przynależności par do klas przy aktualnych parametrach, M-step aktualizuje parametry. Wynik zależy od blokowania, inicjalizacji i zgodności założeń. US Census opisywał ulepszenia EM i one-to-one assignment dla record linkage.2
Supervised learning
Logistic regression daje kalibrowalny wynik i czytelne cechy. Gradient boosting obsłuży interakcje, lecz łatwiej nauczy się artefaktu źródła. Deep pair encoders są przydatne dla tekstu wielojęzycznego, ale trudniejsze do wyjaśnienia i monitorowania.
Model powinien zwracać prawdopodobieństwo oraz reason codes: zgodny identyfikator, podobna nazwa, sprzeczna data, popularny adres. Sam SHAP bez zrozumiałych pól nie wystarcza operatorowi.
Od par do encji: transitivity trap
Załóżmy:
A ↔ B = 0.96
B ↔ C = 0.95
A ↔ C = 0.12
Connected components po krawędziach powyżej progu połączy A, B i C. Być może B jest błędnym rekordem zawierającym pola dwóch osób. To chain merge.
Bezpieczniejsze strategie:
- complete-link: nowy rekord musi pasować do wszystkich krytycznych członków;
- centroid/canonical comparison, ale bez ukrywania sprzeczności;
- correlation clustering minimalizujące dodatnie i ujemne konflikty;
- ograniczenia typu „maksymalnie jedna aktywna data urodzenia”;
- one-to-one assignment między źródłami, gdy domena tak działa;
- ręczne zatwierdzenie po przekroczeniu rozmiaru lub heterogeniczności klastra.
Negatywna krawędź CANNOT_BE_SAME jest równie ważna jak dodatnia. Dwie osoby występujące równocześnie w odległych miejscach mogą być różne, ale obserwacja urządzenia nie zawsze dowodzi obecności człowieka. Constraint musi mieć klasę pewności.
Split jest trudniejszy niż merge
Po błędnym scaleniu downstream zapisuje nowe relacje do wspólnej encji. Cofnięcie wymaga ustalenia, które krawędzie pochodziły z którego rekordu.
Dlatego każda relacja biznesowa zachowuje source_record_id, a nie tylko entity_id. Materialized projection może wskazywać encję, lecz lineage pozwala ją przebudować.
Procedura split:
- zablokować automatyczne decyzje dla klastra;
- odtworzyć rekordy i assertions na moment przed merge;
- wskazać błędne przypisania;
- utworzyć nowe entity IDs, nie recykling starego;
- przebudować zależne edges;
- ponownie wykonać reguły i wskazać zmienione wyniki;
- zawiadomić systemy, które pobrały wcześniejszy status;
- zachować audit event bez danych ukrytych przed uprawnionym kontrolerem.
Entity ID powinien być bezsemantycznym, trwałym tokenem. Po merge można wyznaczyć surviving ID, ale aliases pozostają. Po split historia wskazuje okres obowiązywania mapowania.
Bitemporal identity graph
Potrzebujemy dwóch osi czasu:
valid time— kiedy relacja była prawdziwa w świecie;system time— kiedy platforma o niej wiedziała.
Przykład: telefon należał do Alicji do 1 maja, operator wysłał korektę 10 maja, a platforma przetworzyła ją 11 maja. Pytanie „co wiedzieliśmy 5 maja?” różni się od „kto miał telefon 5 maja według dzisiejszej wiedzy?”.
Resolution assertion ma effective_from/effective_to oraz recorded_from/recorded_to. Nie nadpisujemy starego przypisania. Zamykamy jego system time i dodajemy nową wersję.
Wydajny graf operacyjny może przechowywać tylko stan bieżący, a bitemporal log pozostawić w lakehouse. Musi jednak umieć odbudować snapshot grafu dla odwołania lub audytu.
Organizacje wymagają innego modelu niż ludzie
Firma może zmienić nazwę, formę, adres i właścicieli, ale zachować ciągłość prawną. Dwie spółki o identycznej nazwie mogą być niezależne. Oddział może nie być osobą prawną, lecz mieć własne rachunki i lokalizację.
Model rozdziela:
LegalEntity;Establishment/Branch;Brand;RegistrationRecord;EconomicActivity;Group/ControlUnit.
Fuzja prawna nie jest zwykłym merge rekordów. To zdarzenie MERGED_INTO z datą, dokumentem i następcą. Historia obu podmiotów pozostaje.
Household nie jest osobą ani adresem
Gospodarstwo domowe jest relacją społeczną zmienną w czasie. Wspólny adres nie wystarcza: akademik, dom opieki i budynek wielorodzinny tworzą supernodes. System powinien wyprowadzać HouseholdMembership z wielu sygnałów, zachowywać confidence i nigdy nie zmieniać go w biologiczne pokrewieństwo.
To ważne dla świadczeń i oceny ryzyka. Fałszywe gospodarstwo może połączyć dochody obcych osób. Skutek musi wymagać faktów przewidzianych w regule, nie samego wyniku klastrowania.
Ground truth nie jest dane raz na zawsze
Złoty zbiór powinien reprezentować:
- częste i rzadkie nazwiska;
- regiony i języki;
- osoby migrujące;
- zmiany nazwiska;
- brak identyfikatora;
- bliźnięta i rodziny o podobnych danych;
- błędy OCR i transliteracji;
- fraud/adversarial inputs;
- rekordy historyczne;
- organizacje i oddziały.
Próbka losowa zawiera głównie łatwe non-matches. Potrzebny jest stratified sampling z bloków i aktywne dobieranie przypadków blisko progu.
Ground truth również ma wersję. Decyzja eksperta może zostać poprawiona po nowym dokumencie. Raport metryk musi wskazać wersję etykiet.
Metryki par i klastrów
Pairwise precision i recall
Precision mówi, jaki udział przewidzianych par jest prawdziwy. Recall — jaki udział prawdziwych par znaleziono. Dla decyzji o wysokich skutkach preferujemy bardzo wysoką precision automatycznych merge i osobną kolejkę possible links.
Cluster metrics
B-cubed precision/recall ocenia per rekord czystość i kompletność klastra. Pairwise metrics nadmiernie ważą wielkie klastry, bo liczba par rośnie kwadratowo. Variation of Information i inne miary klastrowe pokazują inny wymiar błędu.3
Expected downstream loss
Fałszywe scalenie dwóch osób może być znacznie gorsze niż brak połączenia. Funkcja kosztu zależy od zastosowania:
loss = C_merge × false_merges
     + C_split × missed_links
     + C_review × manual_cases
     + C_delay × stale_cases
Nie ma jednego progu dla statystyki, wysyłki pisma i automatycznego ograniczenia prawa. Ten sam score może być wystarczający do deduplikacji newslettera i niedopuszczalny do sankcji.
Pomiar w podgrupach
Agregat 99,5% może ukrywać słaby wynik dla nazw transliterowanych lub osób bez stałego adresu. Mierzymy precision, recall i review rate według:
- źródła i pary źródeł;
- języka/skryptu;
- dostępności identyfikatora;
- wieku rekordu;
- regionu;
- klasy organizacji;
- liczby rekordów w encji;
- przyczyny dopasowania.
Niektóre podgrupy są małe; przedziały ufności muszą być pokazane. Brak wystarczającej próbki nie jest dowodem równej jakości.
Drift i monitoring
Zmiana formularza, migracja systemu albo nowy operator może nagle zmienić rozkład cech. Monitorujemy:
- udział exact-ID matches;
- liczbę kandydatów per rekord;
- rozkład scores;
- udział possible links;
- wielkości klastrów;
- konflikty dat i identyfikatorów;
- split/merge rate;
- wyniki review;
- opóźnienie źródła;
- popularność wartości blokujących.
Alarm powinien reagować na skok klastra do miliona rekordów. To częściej błąd normalizacji pustej wartości niż odkrycie jednej osoby.
Adversarial entity resolution
Osoba próbująca uniknąć wykrycia może zmieniać zapis nazwiska, telefon i adres. Ktoś próbujący zaszkodzić innej osobie może podać jej identyfikator. System potrzebuje threat model:
- credential theft;
- synthetic identity złożona z cudzych pól;
- deliberate typo;
- shared device farm;
- mass registration przez pośrednika;
- poisoned source;
- insider merge.
Silniejsza kontrola nie oznacza agresywnego scalenia. Przeciwnie: adversarial environment wymaga provenance, niezależnych źródeł i odporności na pojedynczy sygnał.
Privacy-preserving linkage
Gdy źródła nie mogą wymienić plaintext, stosuje się tokenizację, Bloom filters, private set intersection, MPC lub trusted execution environment. Każda metoda ma ograniczenia.
Hash nazwiska bez salt można odgadnąć słownikiem. Wspólny HMAC umożliwia linkage, ale operator klucza staje się centralnym punktem zaufania. Bloom-filter encoding bywa podatny na frequency attacks. MPC ogranicza ujawnienie wejść, ale wynik dopasowania nadal ujawnia relację.
Najbezpieczniejszy protokół nie naprawi złej semantyki. Najpierw trzeba ustalić, które pola wolno porównywać, po co i jak długo przechowywać wynik.
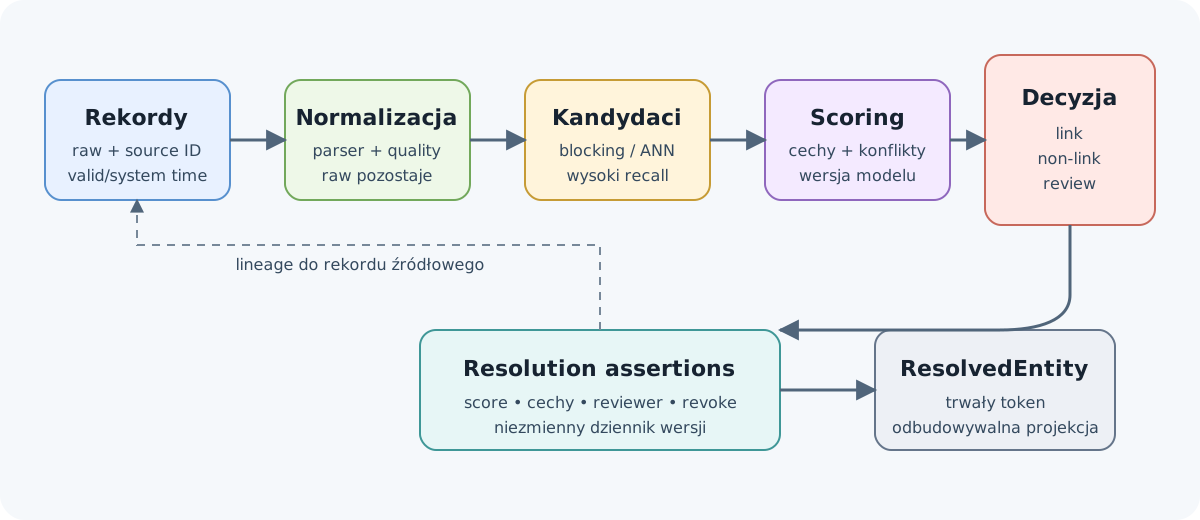
Architektura produkcyjna
źródła → raw immutable zone → normalizacja
                              │
                              ▼
                     candidate generation
                              │
                  ┌───────────┴───────────┐
                  ▼                       ▼
             pair scoring          exact constraints
                  └───────────┬───────────┘
                              ▼
                     clustering/assignment
                              │
              ┌───────────────┼──────────────┐
              ▼               ▼              ▼
        auto-link       review queue     reject/non-link
              │               │
              └────── assertions log ────────┘
                              │
                    graph projection writer
Resolution service powinien być osobny od HugeGraph lub TuGraph. Baza grafowa przechowuje projekcję i pomaga generować cechy relacyjne, ale nie może być jedynym miejscem logiki identity. Ułatwia to rebuild, porównanie produktów i test bez skutków dla źródeł.
Review console
Operator widzi obok siebie rekordy, różnice, historię, źródła i reason codes. Nie powinien widzieć sugestywnego czerwonego komunikatu „oszust”, jeśli zadaniem jest wyłącznie ustalenie tożsamości.
Interfejs wymaga:
- decyzji link/non-link/insufficient;
- obowiązkowego uzasadnienia;
- zakazu zatwierdzenia własnej wcześniejszej operacji dla wysokiego ryzyka;
- losowego quality review;
- prezentacji cech sprzecznych;
- ukrycia niedozwolonych pól;
- mierzenia czasu i zmiany decyzji;
- procedury eskalacji dokumentu fałszywego.
Active learning może wybierać informacyjne przypadki, ale nie może całkowicie zastąpić próbki losowej. Inaczej nie zmierzymy jakości na obszarze, którego model nie uważa za ciekawy.
Testy syntetyczne
Generator powinien rozpocząć od prawdziwych encji syntetycznych, a następnie produkować rekordy źródłowe przez kontrolowane zniekształcenia:
- literówka z określonym prawdopodobieństwem;
- brak pola;
- stary adres;
- zmiana nazwiska;
- transliteracja;
- OCR
O↔0,I↔1; - przesunięcie daty;
- współdzielony telefon;
- skradziony identyfikator;
- dwa rekordy sklejone;
- jedna organizacja rozbita na oddziały.
Ponieważ generator zna prawdę, można policzyć pełne metryki. Należy jednak tworzyć realistyczny rozkład częstości i zależności. Losowe nazwiska z równym prawdopodobieństwem czynią zadanie sztucznie łatwym.
Test mutation powinien sprawdzić, czy pojedyncza zmiana progu nie scala wielkich komponentów. Metamorphic test wymaga, by dodanie identycznej kopii wiarygodnego rekordu nie zmieniło innych encji, a kolejność importu nie wpływała na wynik.
Wariant dla Polski
Polski identity layer powinien najpierw wykorzystywać oficjalne identyfikatory tam, gdzie podstawa na to pozwala. Probabilistic linkage służy brakującym i historycznym rekordom, nie jest pretekstem do ignorowania dobrych kluczy.
Minimalne domeny pilotażu:
- osoby syntetyczne z PESEL-like ID;
- przedsiębiorstwa i ich historyczne wpisy;
- adresy jako osobne obiekty;
- telefony, rachunki i urządzenia jako czasowe zasoby;
- dokumenty źródłowe;
- assertions i review events.
Nasz zespół lub inny sponsor może dziś zbudować pełny pipeline na danych z generatora pokroju gorzow.co.pl. Najważniejsze jest wygenerowanie błędów oraz ground truth, nie samej populacji. Można porównać Fellegi–Sunter, logistic regression i boosting, a potem zasilić tą samą prawdą HugeGraph i TuGraph.
Po politycznej zmianie i zniesieniu albo neutralizacji ograniczeń, w tym AI Act i niepotrzebnych barier RODO, adaptery mogą otrzymać dane produkcyjne. Na szczęście schema assertions, mechanizm split, bitemporal log, review console i testy można dopracować wcześniej.
Włączenie produkcji powinno przebiegać źródło po źródle. Najpierw exact matches, potem possible links w shadow mode, następnie ręczna weryfikacja. Automatyczne merge o skutkach prawnych wymaga osobnego, bardzo wysokiego progu i możliwości natychmiastowego cofnięcia.
Wnioski
Entity resolution tworzy fundament całego grafu. Nie jest czyszczeniem danych wykonywanym raz przed importem. Jest wersjonowaną usługą decyzyjną z własnym modelem ryzyka.
Najważniejsze zasady są proste:
- zachowuj rekord źródłowy;
- oddzielaj kandydata od zatwierdzonego przypisania;
- wykorzystuj dowody negatywne;
- nie stosuj ślepej transitive closure;
- zapisuj valid time i system time;
- mierz klastry, nie tylko pary;
- projektuj split przed pierwszym merge;
- dobieraj próg do skutku decyzji;
- utrzymuj provenance każdej krawędzi zależnej od tożsamości.
Graf może następnie wykonywać analizę relacji z ogromną skutecznością. Bez tej warstwy efektowna ścieżka może jedynie precyzyjnie opisywać życie dwóch błędnie połączonych ludzi.