
Relacyjna baza świetnie przechowuje osobę, firmę, decyzję i rachunek. Trudność zaczyna się przy pytaniu: jak te obiekty łączą się przez kilka pośrednich relacji i czy układ połączeń przypomina znany wzorzec?
Graf zapisuje encje jako wierzchołki, a relacje jako krawędzie. Zamiast wykonywać serię joinów, przechodzi po bezpośrednim sąsiedztwie. Pozwala znaleźć wspólny telefon pięciu przedsiębiorstw, drogę własności do osoby kontrolującej, grupę kont krążących wokół tych samych urządzeń albo powiązanie alertu z kamerą, pojazdem i sprawą.
Ta siła jest niebezpieczna. Graf wyjątkowo łatwo zamienia prawdziwy fakt „A zna B” w nieuprawniony wniosek „A jest taki jak B”. Powiązanie nie jest winą, centralność nie jest intencją, a podobieństwo struktury nie jest dowodem tożsamości. Dobrze zbudowany system wykorzystuje graf do znalezienia ścieżki i jej źródeł; decyzję opiera na faktach, prawie i zweryfikowanym kontekście.
Ten artykuł wyjaśnia teorię i modelowanie niezależnie od produktu. Osobne części serii opisują Apache HugeGraph, TuGraph, uzgadnianie tożsamości oraz dwa kompletne projekty analityczne. Dzięki temu pojęcia takie jak ścieżka, temporal graph, supernode czy centralność nie zostają pomylone z funkcją konkretnej bazy.
Jak czytać tę serię
Podkategoria prowadzi od pojęć do dwóch kompletnych wdrożeń:
- ten artykuł — teoria, model domenowy, ścieżki, algorytmy i granice wnioskowania;
- Entity resolution: tożsamość, czas i pochodzenie danych — jak bezpiecznie ustalić, które rekordy opisują tę samą encję;
- Apache HugeGraph od środka — Server, Gremlin, graphspaces, Loader, backendy i OLAP;
- TuGraph od środka — LMDB, Cypher, procedury, algorytmy i granice Community/Enterprise;
- Projekt HugeGraph: sieć wpływu w syntetycznym mieście — analiza relacji wokół zamówień;
- Projekt TuGraph: skoordynowane sieci wniosków i urządzeń — analiza gospodarstw, pośredników, rachunków i urządzeń.
Teoria jest wspólna, lecz projekty nie są tłumaczeniami Gremlin↔Cypher. Celowo mają inne dane, topologię, metryki błędu i model operacyjny.
Graf nie jest rysunkiem
Diagram z kółkami i liniami jest wizualizacją. Baza grafowa jest silnikiem, który przechowuje sąsiedztwo, właściwości, indeksy i transakcje oraz wykonuje przejścia.
Najczęściej używany w bazach operacyjnych jest labeled property graph:
- vertex ma identyfikator, jedną lub więcej etykiet i properties;
- edge łączy dwa vertices, ma kierunek, etykietę i properties;
- schema określa dozwolone typy oraz pola zależnie od produktu;
- query znajduje wzorzec albo wykonuje traversal.
Przykład:
(Person {person_id: "P123"})
   -[:OWNS {share: 0.60, valid_from: "2025-01-01"}]->
(Company {uscc: "913..."})
Krawędź OWNS jest samodzielnym faktem. Może mieć udział, datę początku, źródło i identyfikator dokumentu. W tabeli relacyjnej odpowiadałaby rekordowi z dwoma kluczami obcymi. Przewaga grafu pojawia się przy wielu krokach i zmiennych wzorcach, nie przy samym przechowaniu jednej relacji.
Property graph a RDF
RDF przedstawia informację jako trójki subject–predicate–object i często używa globalnych URI oraz ontologii. SPARQL wyszukuje wzorce trójek. Property graph naturalnie dołącza właściwości do wierzchołków i krawędzi oraz używa języków traversal/pattern, takich jak Gremlin i Cypher.2
Oba modele potrafią reprezentować podobną wiedzę, ale mają inne ekosystemy i semantykę. RDF jest mocny w wymianie semantycznej, ontologiach i linked data. Property graph jest popularny w analizie operacyjnych sieci, fraud detection i ścieżkach.
Wybór nie powinien wynikać z obrazka. Jeżeli państwo chce publikować słownik pojęć i łączyć otwarte dane, RDF może być właściwy. Jeżeli analityk ma wykonywać tysiące niskolatencyjnych przejść po rachunkach i urządzeniach, property graph może być prostszy.
Kiedy relacyjna baza nadal wygrywa
Pytanie o bieżący status jednej licencji jest prostym lookupem. Relacyjna tabela ma klucz, constraint, transakcję i dojrzały SQL. Graf nie daje tu magicznej korzyści.
Relacyjny model jest lepszy, gdy:
- dominują pojedyncze rekordy i raporty tabelaryczne;
- transakcja obejmuje wiele obiektów biznesowych;
- schema jest stabilna i dobrze znormalizowana;
- zapytania mają mało joinów o znanych ścieżkach;
- potrzebne są dojrzałe narzędzia księgowe i audytowe.
Graf jest lepszy, gdy:
- ścieżka ma zmienną długość;
- pytanie zaczyna się od sąsiedztwa;
- relacja ma własne znaczenie i historię;
- występują cykle, społeczności i wzorce;
- liczba typów relacji jest duża;
- wynik ma pokazać konkretną ścieżkę wyjaśnienia.
Najczęściej system używa obu. Baza transakcyjna pozostaje źródłem, a graf jest odbudowywalną projekcją analityczną.
Dlaczego wieloskokowy join robi się trudny
Załóżmy, że chcemy znaleźć firmy, które przez właścicieli, telefony i rachunki są połączone z podmiotem z listy.
W SQL potrzebne są kolejne self-joiny lub recursive CTE. Dla każdej odmiennej ścieżki powstaje nowa kombinacja. Optymalizator musi oszacować cardinality po wielu joinach.
Graf przechowuje adjacency: dla vertex wiadomo, jakie edges z niego wychodzą. Traversal zaczyna od podmiotu i rozwija sąsiadów. Koszt nadal istnieje — graf nie łamie matematyki — ale dostęp jest dostosowany do ścieżek.
SQL:    tabela edge JOIN edge JOIN edge JOIN edge
Graf:   start → expand → filter → expand → path
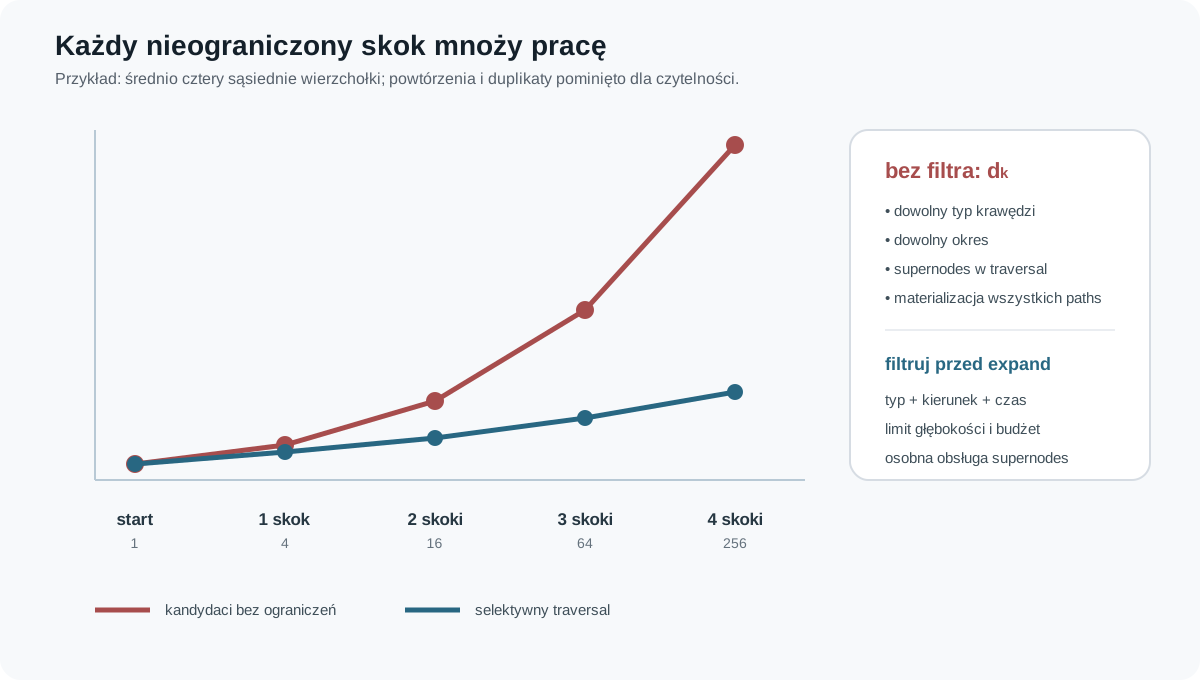
Jeżeli każdy wierzchołek ma średnio 100 sąsiadów, cztery nieograniczone kroki mogą rozwinąć nawet 100 milionów przejść. Dlatego dobry query filtruje typ, kierunek, czas i stopień jak najwcześniej.
Model domenowy: wierzchołek nie powinien znaczyć wszystkiego
Praktyczny graf informacji publicznej może zawierać:
Encje
Person— osoba z wewnętrznym identyfikatorem;Organization— firma, urząd, fundacja, partia;Address— znormalizowany punkt/adres;Phone,Email,Device,Account— zasób komunikacyjny lub techniczny;Vehicle— pojazd;Camera— urządzenie obserwacyjne;Decision,Case,Licence— obiekt prawno-procesowy;Event— zdarzenie z czasem i źródłem;Document— dokument dowodowy albo rejestrowy.
Relacje
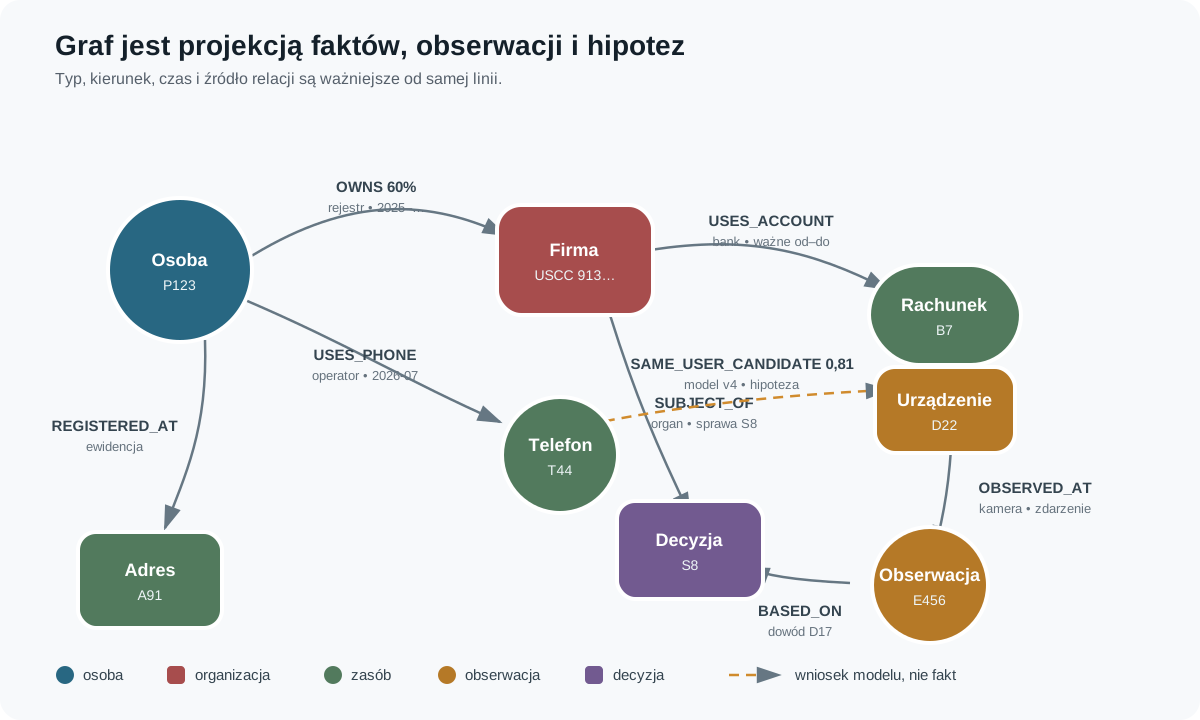
OWNS,CONTROLS,EMPLOYED_BY;REGISTERED_AT,USES_PHONE,USES_DEVICE;TRANSFERRED_TO;OBSERVED_AT,CAPTURED_BY;SUBJECT_OF,ISSUED_BY,BASED_ON;PARENT_OF,SAME_ENTITY_CANDIDATE;MENTIONED_IN.
Nie należy tworzyć uniwersalnej krawędzi RELATED_TO. Traci kierunek, podstawę i znaczenie. „Mieszka pod adresem” jest inne niż „firma była zarejestrowana pod adresem”, a oba są inne niż „telefon zalogował się w pobliżu”.
Fakt, obserwacja i hipoteza muszą być różnymi typami
Najważniejszy podział modelu:
- fakt rejestrowy — źródło twierdzi, że relacja istnieje;
- obserwacja — urządzenie lub operator zarejestrował zdarzenie;
- wniosek — algorytm uważa, że relacja jest prawdopodobna;
- decyzja — uprawniony organ zatwierdził skutek.
Krawędź OWNS z rejestru nie może być przechowywana identycznie jak PROBABLY_SAME_PERSON z modelu. Inaczej kolejny algorytm potraktuje hipotezę jak pewny fakt i wzmocni własny błąd.
Minimalne properties relacji:
source_system
source_record_id
observed_at / valid_from / valid_to
ingested_at
evidence_uri lub evidence_id
confidence
assertion_type: fact | observation | inference | decision
model_version, jeśli inference
confidence nie powinno istnieć na fakcie urzędowym tylko po to, by wszystko miało jedno pole. Dla faktu istotniejsze są status, ważność i możliwość sprostowania.
Tożsamość: jeden człowiek czy dwa vertices
Graf jest szczególnie podatny na błędy entity resolution. Jeżeli dwie osoby zostaną scalone, ich całe sąsiedztwa się połączą. Jeżeli jedna osoba pozostanie w dwóch vertices, algorytm nie zobaczy części relacji.
Bezpieczny model rozdziela:
SourcePersonRecord— rekord w konkretnym systemie;Person— uzgodniona encja;IDENTIFIES— relacja przypisania rekordu do encji;SAME_ENTITY_CANDIDATE— niezatwierdzona propozycja.
[Record A] ─IDENTIFIES→ [Person P123] ←IDENTIFIES─ [Record B]
[Record C] ─SAME_ENTITY_CANDIDATE {0.81}→ [Person P123]
Scalenie powinno być odwracalne. System przechowuje wersję reguły, użyte cechy, wynik i zatwierdzającego. Analityk musi widzieć, które krawędzie zależą od niepewnego dopasowania.
Czas w grafie
Graf bez czasu szybko staje się fałszywy. Osoba była członkiem zarządu od 2020 do 2022, rachunek należał do firmy do czerwca, a adres został zmieniony.
Są dwa podstawowe modele.
Czas na krawędzi
Krawędź ma valid_from i valid_to. Query filtruje relacje obowiązujące w chwili T.
MATCH p=(a:Person)-[r:OWNS]->(c:Company)
WHERE r.valid_from <= $t
  AND (r.valid_to IS NULL OR$t < r.valid_to)
RETURN p
Relacja jako vertex
Jeżeli relacja ma wiele dokumentów, stron i zmian, można zrobić z niej vertex OwnershipRecord, połączony z osobą, firmą i dokumentem. Model jest bardziej rozbudowany, ale lepiej obsługuje provenance.
Należy rozróżnić valid time od system time. Właściciel zmienił się 1 maja, ale rejestr otrzymał dokument 10 maja. Analiza historyczna może pytać zarówno o rzeczywistość prawną, jak i o wiedzę systemu danego dnia.
Cypher: deklaratywny wzorzec
Cypher opisuje wzorzec za pomocą ASCII-art.
MATCH p = (person:Person {person_id: $id})
          -[:CONTROLS|OWNS*1..4]->
          (company:Organization)
WHERE ALL(r IN relationships(p)
          WHERE r.valid_from <=$at
            AND (r.valid_to IS NULL OR $at < r.valid_to))
RETURN company, p
LIMIT 100
Silnik wybiera plan: start od indeksu person_id, rozwija właściwe krawędzie, filtruje czas i ogranicza wynik. Variable-length path bez limitu może przejść ogromny graf albo cykle. Produkcyjny endpoint powinien narzucać maksymalną głębokość, timeout i limit pamięci.
Cypher jest czytelny dla wzorców. Standardem międzynarodowym stał się ISO/IEC 39075:2024 GQL, ale produkty implementują różne zakresy openCypher/Cypher/GQL. Zgodność składni nie gwarantuje identycznej semantyki planu, transakcji i paths.3
Gremlin: traversal jako kompozycja kroków
Gremlin jest językiem Apache TinkerPop. Traversal powstaje przez łączenie kroków map, flatMap, filter, sideEffect i branch. Obiekt traverser niesie aktualny element oraz — gdy potrzebne — historię ścieżki.1
g.V().has('Person', 'person_id', personId)
 .repeat(
   outE('OWNS', 'CONTROLS')
    .has('valid_from', lte(at))
    .inV()
    .simplePath()
 )
 .times(4)
 .hasLabel('Organization')
 .path()
 .limit(100)
Gremlin jest bardziej proceduralny w sposobie myślenia: wybierz start, przejdź krawędzią, filtruj, powtórz. TinkerPop oddziela strukturę grafu od procesu traversal i pozwala różnym providerom implementować wspólny interfejs.1
path() jest kosztowne, bo traverser musi zachowywać historię. Jeżeli użytkownik potrzebuje tylko końcowych identyfikatorów, nie należy materializować wszystkich ścieżek.
Indeks pomaga znaleźć początek, nie każdy kolejny krok
Graph query zwykle ma dwie fazy:
- znajdź starting vertices przez indeks;
- przechodź po adjacency.
Bez indeksu na person_id silnik może przeskanować wszystkich ludzi. Indeks na każdej property też jest zły: zwiększa zapis, storage i koszt aktualizacji.
Indeksy warto mieć na:
- stabilnych identyfikatorach;
- polach startowych częstych zapytań;
- właściwościach selektywnie filtrujących;
- czasie, jeśli produkt potrafi użyć go w planie;
- kodach typu/statusu.
Właściwość o dwóch wartościach, np. boolean, jest słabo selektywna. Sam indeks może nie pomóc.
Kierunek i podwójne przechowywanie
Graf directed rozróżnia (person)-[:OWNS]->(company) od odwrotności. Zapytania często potrzebują obu kierunków: „co posiada osoba” i „kto posiada firmę”. Silnik może przechowywać adjacency outgoing oraz incoming, co podwaja część indeksu, ale przyspiesza przejścia.
Nie należy tworzyć dwóch semantycznych krawędzi OWNS i OWNED_BY, jeśli są lustrami tego samego faktu. Powstanie ryzyko rozjechania. Lepiej zachować jedną relację i czytać ją w obu kierunkach, o ile silnik wspiera efektywnie.
Supernodes
Supernode ma ekstremalnie dużo krawędzi. Przykłady:
- popularny operator telekomunikacyjny;
- wspólny adres wirtualnego biura;
- wielki urząd;
- jedna kamera na ruchliwym dworcu;
- kod „brak adresu” błędnie zmodelowany jako vertex.
Przejście przez supernode eksploduje. Wspólny operator telefonu nie jest sensowną relacją między wszystkimi abonentami. Wirtualny adres jest słabszą cechą niż prywatny lokal.
Techniki:
- filtr typu i czasu przed expand;
- limit degree dla konkretnego wzorca;
- osobna reprezentacja cechy popularnej;
- partycjonowanie adjacency;
- próbki tylko do eksploracji, nigdy do oficjalnego wyniku;
- statystyki stopnia i alert dla nowego supernode;
- waga odwrotnie proporcjonalna do popularności cechy.
OLTP kontra OLAP grafowy
Graph OLTP
Krótkie zapytanie zaczyna od kilku vertices i przechodzi lokalne sąsiedztwo. Przykład: najkrótsza ścieżka do podmiotu z listy do czterech kroków. Liczy się niska latencja, indeks startowy i lokalność adjacency.
Graph OLAP
Algorytm przechodzi większość grafu wieloma iteracjami. PageRank, connected components i community detection wymieniają wiadomości lub przetwarzają wszystkie edges. Liczy się przepustowość, podział grafu i checkpoint.
Nie należy uruchamiać pełnego PageRank na tym samym serwerze, który odpowiada operatorom. Produkty rozdzielają engine transakcyjny od Computer/Analytics albo eksportują snapshot do Spark/Flink.
Algorytmy: co liczą, a czego nie dowodzą
BFS i shortest path
Breadth-first search rozwija graf warstwami i znajduje ścieżkę o najmniejszej liczbie krawędzi w grafie nieważonym. Dijkstra znajduje najtańszą ścieżkę dla wag nieujemnych.
Najkrótsza liczba kroków nie musi oznaczać najsilniejszej relacji. Droga przez wielki publiczny adres jest krótka, ale informacyjnie słaba. Waga powinna odzwierciedlać sens relacji, a nie arbitralną wygodę.
Connected components
Komponent spójny grupuje vertices połączone jakąkolwiek ścieżką. W grafie z supernodes cały kraj może stać się jednym komponentem. Algorytm jest użyteczny dopiero po wybraniu typów, czasu i progów.
Strongly connected components
W directed graph SCC oznacza, że każdy vertex jest osiągalny z każdego. W przepływach finansowych może ujawnić cykle, ale cykliczny handel nie jest automatycznie oszustwem.
PageRank
PageRank propaguje znaczenie przez incoming links z tłumieniem. W sieci WWW link był głosem. W grafie urzędowym znaczenie OWNS, CALLED i OBSERVED_AT jest różne. Mieszanie ich w jednym PageRank daje efektowną, ale niejasną liczbę.
Degree centrality
Degree to liczba sąsiadów. Wysoki stopień może wskazać pośrednika, ale też bank, urząd, operatora lub popularny sklep. Należy liczyć degree per edge type i porównywać w odpowiedniej klasie.
Betweenness centrality
Mierzy, jak często vertex leży na najkrótszych ścieżkach. Może wskazać brokerów lub punkty łączące grupy. Algorytm Brandesa liczy dokładne betweenness wszystkich wierzchołków grafu nieważonego w czasie O(VE); nadal jest to kosztowne dla państwowej skali, a wynik zależy od definicji ścieżki i wag.4
Community detection
Louvain, label propagation i pokrewne algorytmy szukają gęściej połączonych grup. Louvain jest heurystyką optymalizującą modularność, a nie procedurą odkrywającą jedyny prawdziwy podział.5 Społeczność jest strukturą statystyczną, nie formalną organizacją. Granice mogą zmieniać się przy drobnej zmianie danych lub kolejności.
Triangle counting i clustering coefficient
Trójkąty pokazują lokalne domknięcie relacji. W sieci kontaktów mogą odróżniać społeczność od gwiazdy. W grafie płatności znaczenie jest inne. Wynik bez edge semantics nie ma uniwersalnej interpretacji.
Similarity i link prediction
Common neighbors, Jaccard, Adamic–Adar i modele embedding przewidują podobieństwo lub brakującą krawędź. Mogą tworzyć kandydatów do weryfikacji. Nie wolno materializować przewidzianej relacji jako faktu bez pola assertion_type=inference, wersji modelu i progu.
Motywy i wzorce oszustwa
Reguła grafowa może szukać motywu:
5 firm
  ├─ wspólny telefon
  ├─ naprzemienne przelewy
  ├─ ten sam device fingerprint
  └─ właściciele zmienieni tuż przed wnioskiem
Wzorzec jest bardziej wyjaśnialny niż jedna liczba. Analityk widzi konkretne vertices i edges. Nadal trzeba sprawdzić, czy wspólny telefon nie należy do biura księgowego, device do publicznego terminala, a przelewy do legalnego łańcucha dostaw.
System powinien zwracać:
- dopasowaną ścieżkę/motyw;
- dane źródłowe każdej krawędzi;
- wersję reguły;
- cechy przeciwne hipotezie;
- popularność użytych węzłów;
- brakujące i niepewne dane;
- datę, na którą graf został oceniony.
Dwa silniki w dalszej części serii
Teoria z tego artykułu jest implementowana w dwóch odmiennych otwartych stosach. Apache HugeGraph opiera OLTP na TinkerPop/Gremlin, udostępnia graphspaces i wymienne backendy oraz łączy Server z Loaderem, Hubble i obliczeniami całego grafu. TuGraph stawia na rdzeń C++, lokalny LMDB, strong schema, OpenCypher i procedury blisko danych.
Nie są to dwa zamienniki różniące się nazwą. HugeGraph może rozłożyć storage przez HStore, podczas gdy TuGraph Community jest przede wszystkim silnym silnikiem pojedynczego hosta; szersze HA TuGraph należy do Enterprise. Gremlin opisuje traversal krokami, Cypher wzorzec deklaratywnie. Różnice szczegółowo omawiają artykuły produktowe, a dwa osobne projekty pokazują, jak wpływają na model i operacje.
Dla teorii ważniejsza jest wspólna granica: oba produkty przechowują labeled property graph, ale żaden nie nada semantyki źle nazwanej krawędzi, nie naprawi błędnego entity merge i nie zdecyduje, czy ścieżka jest dowodem. Te obowiązki pozostają w modelu domenowym, provenance i procedurze decyzji.
Partycjonowanie grafu
Podział grafu jest trudniejszy niż tabeli faktów. Edge łączy dwa vertices, które mogą znaleźć się na różnych maszynach. Traversal płaci za sieć.
Edge cut
Vertices są przypisane do partycji, a krawędzie między nimi stają się cross-partition. Celem jest minimalizacja przeciętych edges przy równym obciążeniu.
Vertex cut
Edges są dzielone, a vertex o wysokim stopniu ma repliki w wielu partycjach. Pomaga dla power-law graph, ale wymaga synchronizacji properties.
Partycja domenowa
Podział po regionie administracyjnym poprawia lokalność relacji lokalnych. Firmy, telefony i transakcje przekraczają jednak granice. Zapytanie między województwami może stać się drogie i — co gorsza — analiza może nie zobaczyć odciętej części.
Wymóg suwerenności terytorialnej trzeba pogodzić z kompletnością. Możliwa jest lokalna kopia oraz centralny indeks relacji międzyregionowych z minimalnymi properties.
Aktualizacja grafu z rejestrów
Graf nie powinien otrzymywać dual write bezpośrednio z każdej aplikacji. Zalecany pipeline:
system źródłowy
   │ transaction + outbox/CDC
   ▼
Kafka: zdarzenie domenowe
   │
   ├─► walidacja identity/provenance
   │
   ├─► graph projection writer
   │      ├─ upsert vertex
   │      ├─ close old edge validity
   │      └─ insert new edge
   │
   └─► immutable archive
Writer powinien być idempotentny po event_id. Dla encji przechowuje aggregate_version i odrzuca zdarzenie starsze niż aktualna wersja albo kieruje je do procesu porządkującego.
Nie każda zmiana properties wymaga przebudowy wszystkich edges. Event powinien mówić, co zmieniono, ale pełny snapshot okresowy sprawdza drift.
Rebuild i blue–green graph
Duży błąd modelu może wymagać odbudowy. Zamiast modyfikować graf w miejscu:
- utworzyć
graph_v2z nowym schema; - załadować snapshot źródeł;
- odtworzyć późniejsze zdarzenia od watermark;
- porównać vertices, edges i wyniki wzorców;
- uruchomić shadow queries;
- przełączyć alias/router;
- zachować v1 przez ograniczony okres rollback;
- bezpiecznie usunąć v1 po zatwierdzeniu.
Graf powinien mieć manifest: liczba elementów per label, zakres czasu, offsety źródeł i hash wersji schematu.
Kontrola jakości grafu
Metryki jakości obejmują:
- vertices bez stabilnego źródła;
- edges do nieistniejących vertices;
- relacje bez
source_record_id; - nakładające się okresy niemożliwej wyłączności;
- liczba kandydatów entity resolution;
- skok stopnia popularnych vertices;
- pętle niedozwolone dla konkretnego edge label;
- nieoczekiwane komponenty/supernodes;
- rozbieżność względem tabel źródłowych;
- opóźnienie projekcji;
- odsetek inference użytych w wynikach.
Pętla (person)-[:PARENT_OF]->(person) jest błędem. Pętla przelewu własnego może być prawdziwa. Reguły zależą od typu.
Wyjaśnialność zapytania grafowego
Wynik nie powinien być tylko risk=87. Powinien zawierać podgraf uzasadniający:
Person P123
  └─ OWNS 60% [register R, document D, valid 2025-...]
      Company C9
        └─ USES_ACCOUNT [bank report B, valid ...]
            Account A7
              └─ TRANSFERRED_TO [tx T, 2026-...]
                  Listed Company C2
Każda krawędź powinna być klikalna do źródła dostępnego użytkownikowi. Jeżeli źródło jest tajne, interfejs pokazuje co najmniej klasę źródła i procedurę uzyskania wyjaśnienia. Brak prawa do poznania tajnego dokumentu nie może oznaczać braku audytu wewnętrznego.
„Wina przez skojarzenie” jako błąd techniczny
Niebezpieczeństwo nie wynika wyłącznie z polityki. Jest także błędem statystycznym.
Jeżeli 1% populacji ma cechę X, a algorytm oznacza 90% z nich, ale także 5% pozostałych, w wielkiej populacji false positives mogą przewyższyć true positives. Dodanie luźnych powiązań zwiększa bazę kandydatów wykładniczo.
Graf powinien zatem rozdzielać:
- generowanie kandydatów o wysokiej recall;
- ranking do pracy analityka;
- potwierdzenie faktów;
- decyzję według formalnej reguły.
Automatyczna decyzja może korzystać wyłącznie z relacji, które prawo uznało za relewantne i które mają odpowiednią jakość. Samo „dwa skoki od złej osoby” jest zbyt arbitralne.
Visual analytics: obraz pomaga i oszukuje
Layout force-directed umieszcza gęsto połączone vertices blisko siebie. Odległość na ekranie nie jest metryką prawną ani geograficzną. Rozmiar kółka może reprezentować degree, PageRank lub kwotę — użytkownik musi wiedzieć co.
Dobra wizualizacja:
- pokazuje legendę typów i kierunki;
- filtruje czas;
- oznacza inference linią przerywaną;
- pokazuje źródło po kliknięciu;
- ogranicza liczbę elementów;
- pozwala rozwinąć kolejne sąsiedztwo świadomie;
- nie ukrywa wielokrotnych edges;
- pokazuje, dlaczego vertex znalazł się w wyniku.
Zrzut efektownej „pajęczyny” bez parametrów query nie jest materiałem dowodowym.
Bezpieczeństwo zapytań
Graf może ujawnić informacje przez samą strukturę. Użytkownik bez prawa do danych zdrowotnych może domyślić się roli ukrytego vertex po sąsiadach.
Kontrola wymaga:
- autoryzacji per graph/label/property/edge w miarę możliwości;
- widoków lub fizycznie odseparowanych projekcji dla klas dostępu;
- filtrowania zarówno vertices, jak i edges;
- ograniczenia paths przechodzących przez ukryty element;
- query templates zamiast dowolnego języka;
- limitu głębokości, czasu, wyników i pamięci;
- audit log pełnego zapytania i parametrów;
- rate limiting kosztownych traversals;
- osobnej roli do eksportu podgrafu.
Usunięcie właściwości vertex z wyniku nie wystarcza, jeżeli etykieta i edges zdradzają tożsamość.
Backup, restore i disaster recovery
Backup grafu musi zachować:
- vertices i edges;
- schema oraz indexes;
- users/roles albo procedurę ich odtworzenia;
- procedures/plugins;
- wersję produktu;
- manifest offsetów źródłowych;
- wyniki algorytmów wraz z wersją;
- konfigurację storage i szyfrowania.
Logical export jest przenośny, ale wolny. Physical snapshot jest szybki, lecz związany z wersją i backendem. Potrzebne są oba dla różnych celów.
Test restore powinien uruchomić zestaw zapytań kanonicznych i porównać wyniki, nie tylko policzyć pliki.
Benchmark dla grafu publicznego
Syntetyczny test powinien odtwarzać rozkład stopni i typów. Jednorodny random graph jest łatwiejszy niż rzeczywisty power-law graph z supernodes.
Zestaw zapytań:
- lookup osoby po stabilnym ID;
- 1-hop sąsiedztwo z filtrem czasu;
- 4-hop ścieżka własności;
- shortest weighted path;
- wykrycie motywu wielu firm–jeden telefon;
- temporal query „stan na dzień T”;
- insert/update/close edge;
- masowy import i catch-up CDC;
- PageRank/connected components na snapshot;
- eksport podgrafu z provenance;
- zapytanie atakujące supernode;
- restart i odtworzenie po awarii.
Należy mierzyć p50/p95/p99, visited vertices/edges, pamięć, I/O, ruch sieciowy i czas recovery. Timeout jest prawidłowym wynikiem ochronnym, jeżeli query przekracza budżet.
LDBC SNB i FinBench są dobrym punktem odniesienia, ale własny model temporalny i uprawnienia wymagają osobnego workloadu.11
Graf w chińskich systemach
Police Cloud i platformy public security naturalnie potrzebują analizy ludzi, pojazdów, urządzeń, miejsc, spraw i obserwacji. Social Credit System potrzebuje relacji przedsiębiorstw, właścicieli, decyzji, organów i list. Te domeny mogą korzystać z grafów, lecz nie oznacza to jednego wspólnego graph database.
W praktyce możliwe są:
- lokalny graf policyjny;
- graf własności przedsiębiorstw;
- graf transakcyjny banku;
- graf urządzeń i alarmów miejskich;
- graf wiedzy w chmurze prowincjonalnej;
- doraźny graf budowany w Spark na potrzeby analizy.
HugeGraph i TuGraph są przykładami chińskich technologii zdolnych obsłużyć te wzorce. Konkretne wdrożenie trzeba potwierdzić dokumentacją zamówienia, case study lub źródłem instytucji. Sama funkcjonalna przydatność nie dowodzi użycia.
Wariant architektury dla Polski
Polska powinna budować graf jako projekcję ze zdarzeń, nie centralne miejsce ręcznej edycji prawdy.
rejestry źródłowe → CDC/Kafka → identity service → graph writer
                                            │
                                            ├─ graph OLTP
                                            ├─ snapshot do lake
                                            └─ graph OLAP

aplikacja analityka → katalog zatwierdzonych zapytań → podgraf + provenance
Pierwsze domeny:
- własność i kontrola organizacji;
- decyzje i ich podstawa;
- rachunki/transfery tylko w prawnie określonym zakresie;
- urządzenia i sesje techniczne;
- relacje przestrzenno-czasowe jako observations, nie facts o intencji.
Wybrałbym dwa profile testowe:
- HugeGraph/HStore dla dużego rozproszonego grafu i Gremlin;
- TuGraph Community na bardzo mocnym pojedynczym węźle dla niskiej latencji Cypher, z osobnym planem HA albo porównaniem Enterprise.
Kod domenowy powinien generować neutralny zestaw zapytań testowych. Nie warto udawać pełnej przenośności Gremlin↔Cypher; lepiej utrzymywać niewielką warstwę adaptera i golden results.
Rozdzielenie grafów kompetencyjnych
Jedna baza wszystkich relacji jest wygodna, ale zwiększa skutki błędu i nadużycia. Rozsądniejszy może być federacyjny model:
- każda domena utrzymuje własny graph projection;
- centralny katalog wie, jakie relacje są dostępne;
- zapytanie międzydomenowe wymaga uprawnienia i jest audytowane;
- minimalne cross-domain edges są tokenizowane;
- pełny podgraf powstaje tymczasowo dla konkretnej sprawy.
Wadą jest trudniejszy traversal. Zaletą — ograniczenie masowej eksploracji bez celu. Technologia może umożliwiać silną kontrolę bez rezygnacji ze skuteczności.
System zbudowany przed zmianą prawa
Graf szczególnie dobrze nadaje się do treningu na danych syntetycznych, o ile generator tworzy realistyczne zależności, nie niezależne losowe wiersze. gorzow.co.pl może być źródłem syntetycznych osób i adresów, a dodatkowy generator powinien tworzyć:
- gospodarstwa i firmy;
- właścicieli pośrednich;
- rachunki oraz przelewy;
- telefony i urządzenia współdzielone w realistycznym stopniu;
- kamery, przejazdy i zdarzenia;
- legalne społeczności oraz kontrolowane pierścienie nadużyć;
- supernodes, błędy scalania i brakujące krawędzie;
- historię zmian i korekt.
Możemy wcześniej zbudować schema, loader, reguły provenance, bibliotekę Cypher/Gremlin, algorytmy i interfejs wyjaśniający. Można zmierzyć false positives, koszt czterech skoków, restore i migrację HugeGraph–TuGraph.
Po wygranych wyborach oraz zniesieniu albo neutralizacji ograniczeń unijnych, w tym AI Act, źródła syntetyczne można etapami zastępować legalnymi danymi produkcyjnymi. Najpierw graf powinien działać w shadow mode i odtwarzać znane sprawy bez wpływu na decyzje. Następnie może generować kandydatów do ręcznej weryfikacji. Automatyczne skutki wymagają osobno zatwierdzonych, wąskich reguł.
Na szczęście najtrudniejsze elementy techniczne — temporal graph, supernodes, query budgets, provenance, rebuild i odwracalne entity resolution — da się dopracować przed zmianą prawa. Nie wolno natomiast stroić progu winy na syntetycznej populacji i zakładać, że będzie sprawiedliwy dla realnych ludzi. Produkcyjny rozkład relacji musi zostać zmierzony.
Walk, trail i path to różne obiekty
W potocznym języku każdą sekwencję nazywa się ścieżką. W teorii:
- walk może powtarzać vertices i edges;
- trail nie powtarza edges;
- path prosty nie powtarza vertices;
- cycle wraca do początku;
- geodesic jest najkrótszą ścieżką według wybranej miary.
Różnica ma znaczenie w zapytaniu. Przejście Person→Company→Person→Company może krążyć po tej samej własności i sztucznie zwiększyć liczbę wyników. simplePath() ogranicza cykle, lecz wymaga przechowywania historii traversera. Zakaz powtórzenia vertex może też odrzucić legalny motyw, w którym rachunek pojawia się ponownie.
Przed implementacją reguła musi zdefiniować, jaki obiekt matematyczny dopuszcza i dlaczego. „Do czterech kroków” bez informacji o typach, kierunku i powtórzeniach nie jest specyfikacją.
Graf heterogeniczny i metapaths
W grafie jednego typu ścieżka A-B-C jest stosunkowo czytelna. Graf państwowy jest heterogeniczny: Person, Organization, Address, Device, Case i Document mają różną semantykę.
Metapath opisuje sekwencję typów:
Person → Organization → Procurement → Organization
Person → Application → Device ← Application ← Person
Organization → Address ← Organization
Dwie ścieżki tej samej długości mogą mieć zupełnie inną wartość. Pierwsza może pokazywać rolę w zamówieniu, druga współdzielenie urządzenia, trzecia tylko popularny adres.
Algorytm similarity powinien działać per metapath albo po wyraźnie zdefiniowanym heterogeneous model. Zwykły common-neighbors mieszający Address i Document liczy rzeczy nieporównywalne.
Homofilia, wpływ i wspólny kontekst
Jeżeli połączone osoby mają podobne zachowanie, istnieją co najmniej trzy wyjaśnienia:
- homofilia — podobni ludzie wybierają kontakt;
- wpływ społeczny — kontakt zmienia zachowanie;
- wspólna przyczyna — obie osoby reagują na to samo środowisko.
Graf obserwacyjny zwykle nie rozstrzyga między nimi. Dwie firmy składają podobne oferty, bo się porozumiały, korzystają z jednego doradcy albo odpowiadają na tę samą specyfikację. Wysoka korelacja sąsiadów nie jest estymacją wpływu.
Analiza wpływu wymaga porządku czasowego, cech sprzed relacji, grup porównawczych i założeń przyczynowych. Nawet wtedy latent confounding pozostaje; Shalizi i Thomas wykazali, że homofilia i contagion są zasadniczo splątane w obserwacyjnych badaniach sieci bez mocnych dodatkowych założeń.6 Dlatego nazwa krawędzi INFLUENCED jest zbyt mocna, jeśli system zarejestrował tylko współwystąpienie.
Świat otwarty i znaczenie braku krawędzi
W relacyjnej tabeli NOT NULL daje silne założenie o polu. W grafie brak edge może znaczyć:
- relacja nie istnieje;
- źródło jej nie obejmuje;
- import jest opóźniony;
- użytkownik nie ma uprawnienia, by ją widzieć;
- entity resolution nie połączyło rekordu;
- edge wygasła;
- urządzenie nie zaobserwowało zdarzenia.
To open-world assumption: brak faktu nie jest faktem braku. Reguła „osoba nie ma licencji” nie może opierać się na not(out('HAS_LICENCE')), jeśli graf zawiera tylko część organów.
Negatywne stwierdzenie wymaga kompletnego źródła i zakresu, np. assertion NO_ACTIVE_LICENCE wydanego przez właściwy rejestr na określoną datę. Inaczej system nagradza lub karze jakość integracji zamiast zachowania.
Temporal leakage
Model trenowany na historycznych sprawach łatwo użyje krawędzi, która powstała po decyzji. Przykład: SUBJECT_OF_INVESTIGATION doskonale przewiduje wynik kontroli, ponieważ została dodana wskutek tej kontroli.
Snapshot treningowy musi odtwarzać wiedzę dostępną w chwili predykcji. Dla każdego edge sprawdzamy recorded_at <= prediction_time, nie tylko valid_from. Korekta wpisana później nie może przeciec wstecz do modelu oceniającego wcześniejszą wiedzę.
Podział train/test losowymi edges także przecieka. Sąsiednie rekordy tej samej osoby lub organizacji trafiają do obu zbiorów. Lepszy jest split czasowy, grupowy albo według całych komponentów zależnie od pytania. To nie jest kosmetyczny detal: w temporal network kolejność aktywacji krawędzi może zmieniać osiągalność i dynamikę procesu.7
Niepewność na ścieżce
Jeżeli edges mają confidence 0,9, 0,8 i 0,7, ich iloczyn 0,504 jest poprawny tylko przy określonych założeniach niezależności. Wspólne źródło lub ten sam model powodują korelację. Minimum 0,7 też nie jest uniwersalną prawdą.
Bezpieczniejszy wynik przechowuje wektor:
path_confidence:
  weakest_edge: 0.70
  inferred_edges: 2
  independent_source_groups: 1
  contradictions: 1
  model_versions: [ER-12, REL-4]
Reguła może odrzucić path z więcej niż jedną inference albo wymagać dwóch niezależnych źródeł. Jedna efektowna liczba ukryłaby strukturę niepewności.
Graf multiplex
Te same vertices mogą być połączone w wielu warstwach: rodzina, praca, komunikacja, pieniądze i przestrzeń. Agregacja wszystkich edges do jednej sieci usuwa znaczenie.
W multiplex graph analizuje się warstwy osobno oraz ich przecięcia. Gęsta relacja komunikacyjna plus przepływ środków może być istotniejsza niż każda warstwa sama, ale tylko jeśli czas i kierunek są zgodne. Formalizm sieci wielowarstwowych rozróżnia relacje w obrębie warstwy i między warstwami zamiast z góry spłaszczać je do jednej macierzy sąsiedztwa.8
Warstwy mogą mieć różne uprawnienia. Analityk zamówień widzi własność i dokumenty, lecz nie pełny graf komunikacji. Cross-layer query wymaga celu sprawy i zostawia ślad.
Stabilność wyniku
Algorytm społeczności może zmienić granice po dodaniu kilku edges, a ranking centralności po usunięciu supernode. Oprócz wartości mierzymy stabilność:
- wynik w kolejnych snapshotach;
- wynik po bootstrap/resampling edges;
- wrażliwość na usunięcie popularnych węzłów;
- zgodność kilku algorytmów;
- zmianę po korekcie entity resolution;
- przedział lub rozkład, nie tylko punkt.
Jeżeli osoba jest „centralna” wyłącznie w jednym wariancie filtrów, interfejs musi to pokazać. Stabilna ścieżka oparta na dokumentach jest mocniejsza niż niestabilny globalny ranking.
Wnioski
Graf jest najlepszy wtedy, gdy odpowiedzią ma być ścieżka, wzorzec lub struktura, nie zwykły rekord. Property graph przechowuje vertices, edges i properties; Gremlin opisuje traversal, a Cypher deklaratywny pattern. OLTP obsługuje lokalne sąsiedztwo, OLAP algorytmy całego grafu.
Konkretny silnik wpływa na język, storage i operacje, ale nie zwalnia z teorii. Walk, path, metapath, warstwa grafu, świat otwarty, temporal leakage i niepewność muszą zostać zdefiniowane przed wyborem HugeGraph albo TuGraph.
Najważniejszą częścią grafu państwowego nie jest algorytm. Jest nią semantyka krawędzi. Każda relacja musi mówić, czym jest, skąd pochodzi, kiedy obowiązywała i czy jest faktem, obserwacją czy hipotezą. Dopiero wtedy graf pomaga znaleźć prawdę zamiast produkować efektowną pajęczynę skojarzeń.